

应用市场
悟空应用市场与生态伙伴通过产品级融合,为客户提供全面、专业、领先的产品及解决方案,共建产业互联。
前往应用市场 >

主流的AI CRM系统品牌
做后端开发的朋友,尤其是负责业务系统的,大概率都经历过这样的场景:周一早晨刚上班,销售总监气冲冲地跑过来,说系统卡得动不了,搜个客户名字转圈半分钟,月底冲业绩的关键时刻掉链子,这责任谁担?这时候,作为技术负责人,你心里清楚,大概率又是 CRM 数据库的检索出了问题。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
CRM 系统,客户关系管理,听起来是个管理工具,但在技术实现上,它其实是个典型的数据密集型应用。随着业务跑起来,客户表、跟进记录表、合同表、产品表,数据量是指数级增长的。刚开始几十万能跑,到了几百万、上千万,检索效率就是生死线。很多团队在初期为了快,表结构设计得随意,SQL 写得放飞自我,等到数据量上来了,再想优化,那就是给飞行中的飞机换引擎,难度极大。
今天不聊那些虚头巴脑的理论,咱们就结合实际踩过的坑,聊聊 CRM 数据库到底该怎么搞,才能让检索快起来,让销售不再投诉,让运维不再半夜报警。
提到数据库优化,十个人里有九个会先说“加索引”。这话没错,但太笼统。在 CRM 场景下,索引怎么加,加在哪,是个技术活,更是个业务理解活。
很多初级开发喜欢给每个查询字段都加上索引,觉得这样最保险。结果呢?写入性能大幅下降。CRM 系统里,销售录入信息、更新跟进状态是非常高频的操作。如果你给一个表加了十几个索引,每次 INSERT 或 UPDATE,数据库都要去维护这些索引树,磁盘 IO 蹭蹭往上涨。所以,索引的核心原则是“少而精”。
怎么才算精?得看查询模式。CRM 里最常见的查询是什么?是“按客户名称模糊搜索”,是“按销售负责人筛选”,是“按创建时间范围查询”。对于 customer_name 这种字段,很多人习惯直接建索引然后 LIKE '%keyword%'。这里有个大坑:B+ 树索引对于左模糊查询是无效的。也就是说,LIKE '%张三' 走不了索引,会全表扫描。
那怎么办?如果数据量在百万级以内,可以考虑使用数据库自带的全文本索引(Full-Text Index),MySQL 5.7 之后对中文的支持虽然还得配合分词插件,但比全表扫描强太多。如果数据量更大,或者对搜索体验要求极高(比如要支持拼音搜索、错别字容错),那就别在 MySQL 上死磕了,老老实实上搜索引擎,这点后面细说。
再说复合索引。CRM 的查询条件往往是组合的,比如“查找北京地区、状态为意向、且归属于销售 A 的客户”。这时候,单列索引就没用了,得建复合索引 (region, status, sales_id)。这里涉及到一个“最左前缀原则”。如果你的查询经常不带 region,只带 status,那这个索引就废了。所以,建复合索引之前,得去查慢查询日志,看看真实的业务场景里,哪些字段是经常一起出现的。把区分度高的字段放在索引前面,比如 status 可能只有几个枚举值,区分度低,而 sales_id 区分度高,顺序放反了,索引效果大打折扣。
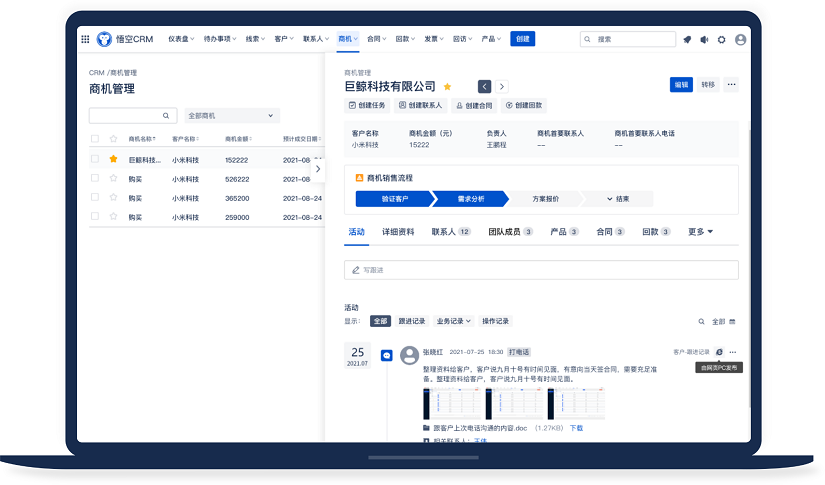
悟空CRM产品截图
还有一个容易被忽视的点:覆盖索引。如果查询只需要返回 id 和 name,而你的索引里正好包含了这两个字段,那数据库就不需要“回表”去查聚簇索引了,直接从索引树拿数据,速度能快一个数量级。在 CRM 的列表页,这种优化特别管用,因为列表页通常只需要展示核心字段,不需要把客户的所有详情都查出来。
说实话,现在的 CRM 系统,数据量稍微上点规模,光靠 MySQL 做检索是很痛苦的。尤其是涉及到多条件组合筛选、全文检索、或者复杂的排序需求时,MySQL 的 WHERE 子句会变得极其臃肿,执行计划怎么看怎么别扭。
这时候,引入 Elasticsearch(ES)几乎是标配方案。ES 倒排索引的机制,天生就是为搜索而生的。把 CRM 的核心数据同步到 ES 里,查询请求走 ES,数据写入走 MySQL,这是经典的架构。
但这里有个老生常谈的问题:数据一致性。销售在 MySQL 里改了一个客户的电话,ES 里要是没同步更新,销售搜出来还是旧号码,这信任感就崩了。怎么解决?
最简单的做法是同步双写,代码里写完 MySQL 紧接着写 ES。但这有风险,万一 ES 写入失败了怎么办?回滚 MySQL?那太复杂了。更稳妥的做法是用 Canal 监听 MySQL 的 binlog,把变更消息发到消息队列(比如 Kafka 或 RocketMQ),然后由消费者异步更新 ES。这样解耦了业务代码,就算 ES 挂了,也不影响主业务流程,消息堆积在队列里,等 ES 恢复了再消费就行。
不过,上了 ES 也不代表万事大吉。ES 本身也是个吃资源的怪兽。分片怎么设?副本几个?这些都得根据数据量来。我见过有团队,数据量才几十万,直接开了 10 个分片,结果查询的时候协调节点要聚合 10 个分片的数据,开销反而比单分片大。对于 CRM 这种写多读也多的场景,分片数不宜过多,一般按单个分片 30GB-50GB 数据量来规划比较合理。
另外,CRM 里的权限控制是个麻烦事。不同级别的销售能看到的数据范围不一样。如果在 ES 查询里硬编码权限逻辑,每次查询都要带上一堆 term 过滤条件,性能会受影响。比较好的做法是在索引设计时,就把 data_scope 或者 owner_id 这种字段设计进去,利用 ES 的过滤缓存(Filter Cache),因为过滤条件不走评分,速度极快。
提到加速,Redis 是绕不开的。但 CRM 系统里,缓存怎么用,很有讲究。
有些团队喜欢把整个客户对象都塞进 Redis 里。客户 A 的信息变了,更新 Redis。听起来很美,但 CRM 的数据关联太复杂了。一个客户下面可能有几十个跟进记录,几个合同,多个联系人。你要是把这些全缓存,更新的时候得维护一堆 Key,一致性很难保证。
更实用的策略是缓存“热点查询结果”或者“字典数据”。比如,CRM 里经常要查“行业分类”、“客户等级”这种几乎不变的数据,直接全量加载到 Redis 里,别每次都查库。对于客户列表的查询,如果条件非常固定(比如“我名下的今日待跟进客户”),可以把查询结果集缓存起来,设置一个较短的过期时间,比如 5 分钟。
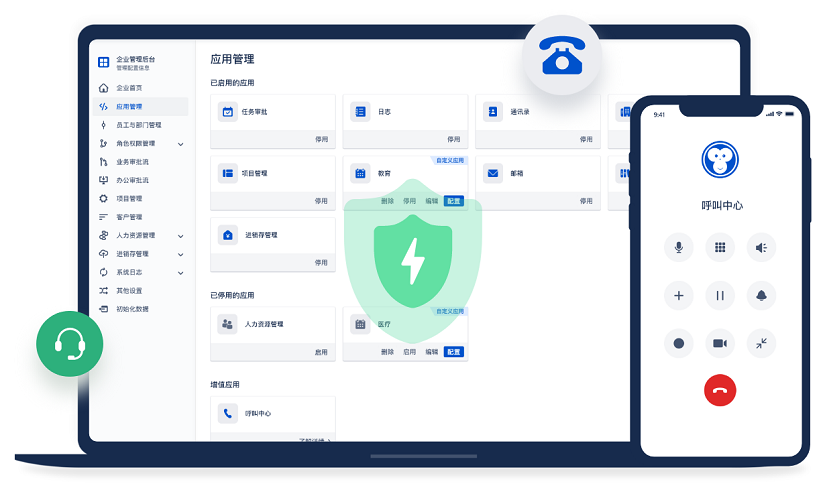
主流的CRM系统品牌
这里有个陷阱:缓存穿透和缓存雪崩。如果销售搜了一个不存在的客户 ID,数据库查不到,缓存也没写,下次还查库。量大一点,数据库就挂了。解决办法是布隆过滤器,或者干脆把空结果也缓存一小会儿。至于雪崩,就是大量缓存同时过期,解决办法很简单,给过期时间加个随机值,别让大家同一时刻失效。
还有一种高级玩法:缓存预热。CRM 系统通常有明显的业务周期,比如周一上午是高峰,月底是高峰。可以在低峰期,通过脚本把预计会热的数据提前加载到缓存里。这需要你对业务节奏非常了解,不是技术能自动解决的。
很多 CRM 系统变慢,不是因为当前业务数据多,而是因为历史数据太多。三年前的一个线索,销售今天还会去查吗?概率很低。但这条数据如果还躺在主表里,就会拖慢所有查询。
所以,冷热数据分离是必须的。主表只保留最近一年或者半年的活跃数据。超过这个时间的数据,迁移到“历史表”或者归档库里。归档库的硬件配置可以低一点,甚至可以用列式存储来做分析。
怎么做归档?别指望人工删。得有个定时任务,每天凌晨跑,把满足条件的数据 INSERT INTO history_table SELECT ... FROM main_table,然后 DELETE FROM main_table。注意,DELETE 操作在 MySQL 里是大事务,会锁表,还会产生大量碎片。更好的做法是“标记删除”或者“按分区表操作”。如果表设计时用了分区(Partitioning),直接 DROP PARTITION,那是秒级的,而且能释放空间。
但归档有个业务风险:销售突然要查三年前的一个合同怎么办?这时候系统得提供一个“查询归档”的入口,或者在应用层做路由,先查主表,查不到再查归档表。这对代码侵入性有点大,但为了性能,值得做。
有时候数据库没毛病,索引也对了,但系统就是慢。这时候得查查代码。
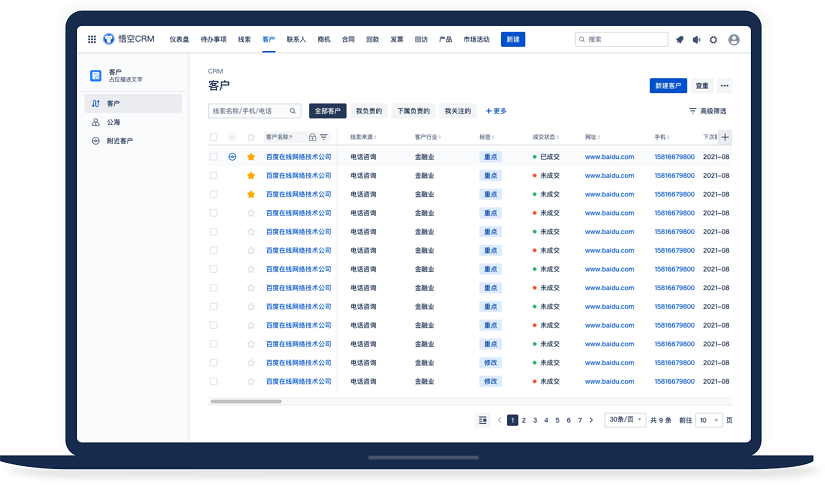
悟空CRM产品截图
最典型的就是 N+1 问题。比如查出一个客户列表,有 20 条数据。然后代码里遍历这 20 个客户,每个客户再去查一次他的跟进记录。这就变成了 1 次查列表 + 20 次查跟进 = 21 次数据库交互。如果列表是 100 条,就是 101 次。网络开销加上数据库连接开销,时间全耗在这上面了。
解决办法很简单:用 IN 查询。先把客户 ID 收集起来,一次性查出所有相关的跟进记录,然后在内存里组装。现在的 ORM 框架(比如 MyBatis Plus 或 Hibernate)虽然方便,但默认配置下很容易写出 N+1 的代码,Code Review 的时候得重点盯着这块。
还有事务控制。有些开发习惯在一个大事务里做所有事:查数据、调外部接口、写日志、发邮件。这导致数据库连接被长时间占用,并发一高,连接池就爆了。CRM 里,尽量把事务范围缩小,只包裹核心的数据库写操作。外部接口调用、非核心的日志记录,全部扔到事务外,或者异步处理。
高效检索不是一劳永逸的。业务在变,数据分布也在变。今天高效的索引,明天可能因为数据倾斜就失效了。
所以,监控体系得跟上。不要只看 CPU 和内存,要看数据库的慢查询日志(Slow Query Log)。设置一个阈值,比如超过 1 秒的查询都记录下来。每天有人去复盘这些慢 SQL,是缺索引?还是逻辑不对?
还有连接数监控。如果连接数经常飙高,说明可能有慢查询占着连接不放,或者连接池配置太小。QPS(每秒查询率)和 TPS(每秒事务数)的趋势图也得看,如果某天 QPS 突然暴涨,是不是哪个新功能上线了,或者哪个销售搞了个批量导出?
我见过一个案例,有个销售为了导数据,写了一个超级复杂的筛选条件,涉及五张表关联,还没走索引。这一跑,整个库的 CPU 直接 100%,其他人全卡住。后来我们在应用层做了限制,复杂查询强制走从库,并且限制了最大执行时间,超时直接杀掉,这才稳住。
聊了这么多技术细节,最后得回归到架构思维上。实现高效检索,本质上是在空间、时间、一致性、复杂度之间做权衡。
用 ES 换来了搜索速度,但增加了架构复杂度和数据一致性风险;用 Redis 换来了读取性能,但增加了内存成本和缓存维护成本;做数据归档换来了主表轻量,但增加了查询逻辑的复杂度。
没有一种方案是完美的。对于初创公司,数据量不大,MySQL 优化好索引,代码写规范点,足够撑很久。别一上来就搞微服务、搞 ES 集群,那是过度设计,维护成本会拖死小团队。但对于成熟期的 CRM,数据量千万级,并发高,那这套组合拳(MySQL+ES+Redis+ 归档)就是必须的。
还有一点,别忽略了业务侧的优化。有时候技术累死累活优化,业务侧改个需求就回去了。比如,限制导出功能,限制复杂筛选的组合条件,引导销售使用更精准的搜索方式。技术和业务得坐下来聊,告诉业务方,什么样的查询是“昂贵”的,让他们在使用习惯上配合一下。
CRM 数据库的高效检索,其实是一场持久战。它不是靠某个神技就能解决的,而是靠日常的规范、监控、迭代。
作为技术人员,我们容易陷入“技术自嗨”,觉得用了最新的引擎、最牛的算法就万事大吉。但真正的高效,是让用户无感知。销售在搜客户的时候,不需要知道背后是 MySQL 还是 ES,他只需要知道,敲下回车,结果立马出来。
所以,下次再遇到检索慢的问题,别急着加机器。先看看慢查询日志,再看看索引设计,再问问业务最近有没有什么新玩法。很多时候,问题就藏在那些不起眼的 LIKE 语句里,或者那段没走索引的关联查询里。
把基础打牢,把监控做好,把架构留有余地。这才是应对数据增长的长久之计。毕竟,系统稳了,大家才能睡个安稳觉,不用半夜起来处理报警短信,这比什么技术都实在。
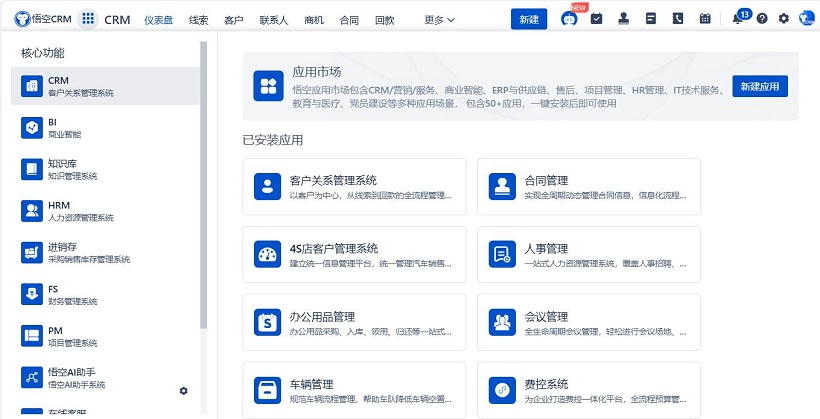
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
悟空CRM产品更多介绍:www.5kcrm.com







 豫公网安备 41010702002713号