

应用市场
悟空应用市场与生态伙伴通过产品级融合,为客户提供全面、专业、领先的产品及解决方案,共建产业互联。
前往应用市场 >

主流的AI CRM系统品牌
凌晨两点,办公室的空调发出轻微的嗡嗡声,屏幕上的光标还在闪烁。这已经是我这周第三次因为 CRM 系统的一个权限 bug 被销售总监的电话吵醒了。电话那头不是安慰,而是咆哮:“为什么小王看不到他刚录入的客户?为什么李总导出的数据少了一行?”
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
挂掉电话,我点了根烟,看着屏幕上那几千行关于 customer_permission 的代码,心里五味杂陈。很多人觉得 CRM(客户关系管理)系统简单,不就是增删改查吗?建个表,存个客户名,记个电话,完事。但只有真正蹲在坑里写过的人知道,CRM 的代码编写,本质上是在用逻辑去翻译复杂的人性、博弈的业务流程以及永远在变的销售策略。
今天不聊那些虚头巴脑的架构理论,就聊聊我这些年踩过的坑,以及如果让我重新拿起键盘,我会怎么去编写这套系统的代码。
很多新手上来就建表:users, customers, orders。这是典型的程序员思维,不是业务思维。在写第一行代码前,你得先拿着白板笔,把销售从拿到一个电话号码到最终签单的全过程画出来。
CRM 的核心不是“客户”,而是“线索的生命周期”。
在代码层面,这意味着你不能简单地把客户状态存成一个 status 字段,比如 0 代表潜在,1 代表意向,2 代表成交。这么写,后期绝对会死得很惨。因为业务会变。下个月销售总监可能说,我们要在“意向”和“成交”之间加一个“合同审核中”;或者要把“潜在”拆分为“市场线索”和“销售线索”。
如果你用的是硬编码的 if (status == 1),那你改起来会想砸键盘。
我的建议是,引入状态机(State Machine)的概念,或者至少把状态配置化。在数据库里,单独建一张 workflow_states 表,定义每个状态的流转规则。代码里不要写死逻辑,而是去查配置。
比如,当一个线索从“初步接触”流转到“需求分析”时,系统需要触发什么动作?是自动分配给资深销售?还是发送一封邮件?这些动作应该抽象成“钩子”(Hooks)。在编写后端逻辑时,我习惯用一个观察者模式。当 Lead 对象的状态发生变更事件时,发布一个 LeadStatusChangedEvent,然后让不同的监听器去处理后续逻辑。这样,以后业务要加个“状态变更时通知企业微信”,你只需要加个监听器,不用去动核心的业务代码。
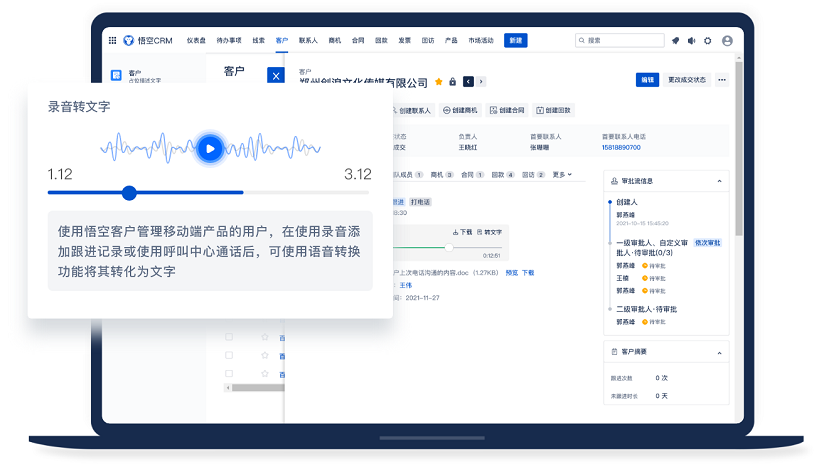
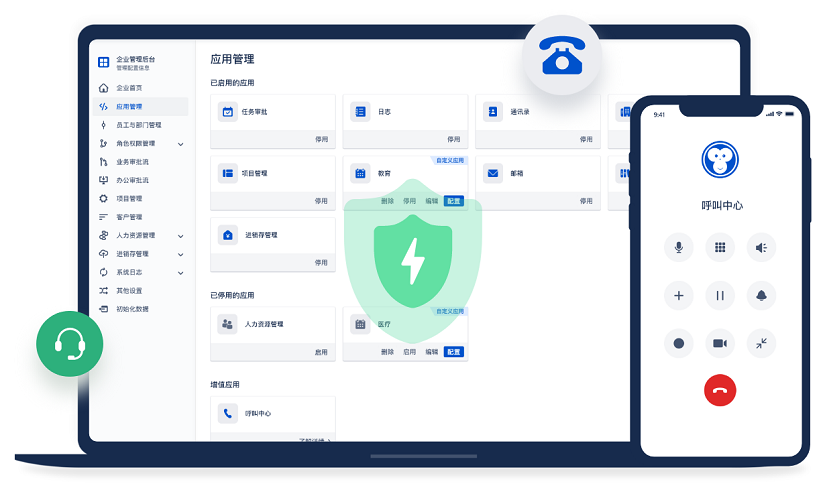
悟空CRM产品截图
这听起来有点过度设计?等你经历过一次因为加个小功能导致整个线索流转逻辑崩盘,半夜回滚代码的时候,你就会感谢现在的自己。
说到数据库,CRM 系统最让人头疼的就是“自定义字段”。
销售团队永远觉得字段不够用。今天想记客户的“生日”,明天想记“公司规模”,后天想记“竞争对手是谁”。如果你每加一个需求就 ALTER TABLE ADD COLUMN,不出半年,你的 customers 表就会有上百个字段,而且大部分是 NULL。查询速度慢得像老牛拉破车,索引也没法建。
早年我试过 EAV 模型(Entity-Attribute-Value),就是搞三张表:实体表、属性表、值表。理论上很灵活,但写起来简直是灾难。稍微复杂点的查询,JOIN 操作能把数据库 CPU 跑满。
后来我学乖了,现在主流的做法是利用现代数据库的特性。如果你用 MySQL 5.7 以上或者 PostgreSQL,直接用 JSON 类型字段。
我会设计一个 custom_fields 的 JSON 列,把那些不固定的信息塞进去。但是,别全塞进去。核心的、需要频繁搜索、排序、做报表的字段,必须独立成列。比如“客户等级”、“跟进状态”、“所属销售”,这些必须是物理字段。而像“客户喜欢的颜色”、“上次见面聊天的备注”这种,扔进 JSON 里。
在代码层面,ORM 框架对 JSON 的支持现在都很好了。但要注意,不要在 JSON 字段里存需要关联查询的数据。我曾经见过有人把“关联的合同 ID"存在 JSON 里,结果做报表统计时,根本没法 JOIN 合同表,最后只能把数据拉到内存里循环处理,数据量一上万,内存直接溢出。
还有一个坑是“跟进记录”(Follow-up Logs)。这是 CRM 里数据量增长最快的表。销售每天可能录入几十条跟进记录。千万别把跟进记录和客户信息混在一起。一定要分表,甚至根据时间分表。
在编写查询跟进记录的代码时,一定要加分页,而且最好是游标分页(Cursor-based Pagination),不要用 OFFSET。为什么?因为当这张表有几百万条数据时,LIMIT 100000, 10 会让数据库扫描前 10 万行然后丢弃,性能极差。用 WHERE id > last_seen_id LIMIT 10 会快得多。这种细节,教科书上不一定讲,但线上崩过一次你就记住了。
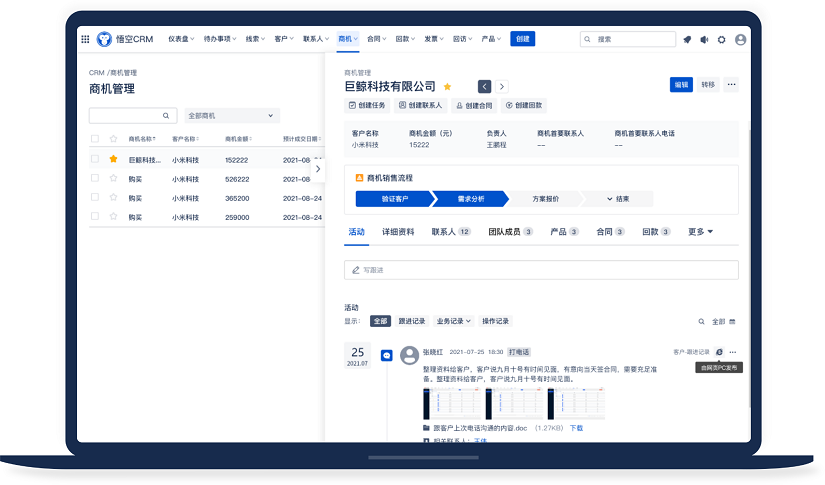
悟空CRM产品截图
CRM 系统的权限,比一般的后台管理系统复杂得多。一般的系统,你要么是管理员,要么是普通用户。但在 CRM 里,权限是数据级的,而且充满了“潜规则”。
销售 A 录入的客户,销售 B 能不能看?销售主管能不能看下属的客户?老板能不能看所有人的?离职员工的客户怎么分配?
如果只在代码里写 if (user.role == 'admin'),那你很快就会陷入无尽的 if-else 地狱。
我现在的做法是,在数据库查询层面做拦截。不管你是用 Hibernate、MyBatis 还是 SQLAlchemy,都要封装一个数据权限过滤器。
比如,当销售 A 查询客户列表时,代码生成的 SQL 应该自动带上 AND (owner_id = current_user_id OR shared_with LIKE '%current_user_id%')。这个逻辑不能散落在每个 Controller 里,必须下沉到 Repository 层或者通过 AOP(面向切面编程)注入。
这里有个特别容易忽略的点:“公海池”逻辑。
很多 CRM 都有公海池,客户没人跟进就会掉进去,别人可以捞。这个逻辑在代码里怎么实现?千万别写定时任务去扫全表,把过期的客户更新状态。数据量大时,这个定时任务会锁表,导致正常业务不可用。
更好的方式是“惰性更新”或者“时间窗口查询”。在查询公海池时,动态计算 last_followup_time + retention_days < now()。或者在每次跟进时,检查是否超时,超时则触发流转。
另外,关于“数据保护”,代码里要留一手。比如,普通销售导出 Excel 时,手机号中间四位必须掩码。这个逻辑不要依赖前端,前端是可以被绕过的。必须在后端接口层,检测到导出动作时,对敏感字段进行脱敏处理。我见过太多因为后端直接返回明文,被销售用爬虫脚本扒走核心数据的案例。
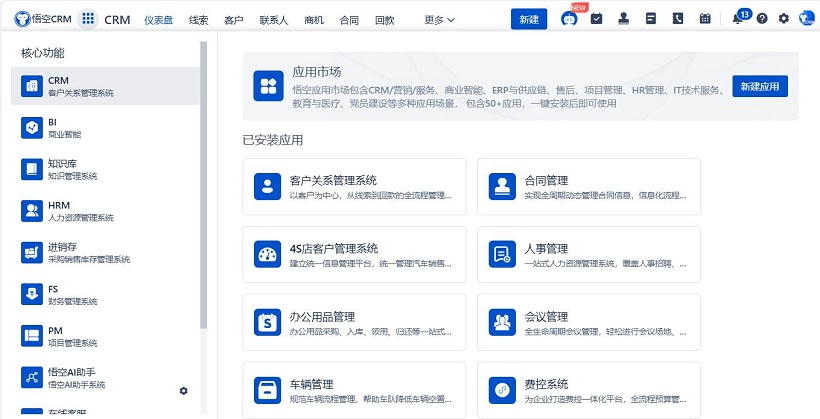
主流的CRM系统品牌
写后端代码时,我们容易陷入逻辑自洽的快感中,但 CRM 的真正用户是销售。他们大多不喜欢复杂的系统,他们想要的是快,是简单。
如果前端代码写得烂,加载一个客户详情页要 3 秒,销售就会弃用,转而继续用 Excel。
在编写前端代码(无论是 Vue、React 还是小程序)时,有几个原则:
第一,减少跳转。能在一个页面完成的,别跳新页面。比如编辑客户信息,用弹窗(Modal)或者抽屉(Drawer),别跳到 /customer/edit/123。销售正在打电话,跳个页面回来,电话都挂了。
第二,异步保存。销售填了一堆信息,点保存,转圈半分钟,报错了,数据没了。这是最让人抓狂的。代码里要做本地缓存,或者采用“自动保存”机制。每填一个字段,防抖(Debounce)后自动调接口存一下。哪怕最后提交失败,数据也在。
第三,移动端优先。现在的销售都在外面跑,用手机多。写代码时,别只盯着 PC 端适配。有些复杂的表格,在手机上根本没法看。这时候代码里要判断 User-Agent,如果是移动端,自动切换成卡片式布局。这不仅仅是 CSS 的问题,接口返回的数据结构可能都要调整。PC 端可能一次返回 50 个字段,移动端为了流量和速度,可能只需要返回 10 个核心字段。这就涉及到后端接口的版本控制或者字段裁剪逻辑(Field Selection)。
你以为把 CRM 写完了?不,真正的痛苦刚开始。
老板会说:“我们要跟企业微信打通,客户加微信自动录入 CRM。” 财务会说:“合同签了要同步到 ERP 系统生成发票。” 市场会说:“官网的表单提交要实时推送到 CRM 线索池。”
每一个集成,都是一次对代码健壮性的考验。
编写这些集成代码时,核心原则是:异步和重试。
千万别在用户点击“保存客户”的主流程里,同步调用企业微信的 API。万一企业微信接口挂了,或者超时了,你的 CRM 保存也会失败。销售会骂你:“连个客户都存不上,什么破系统!”
正确的做法是,主流程只写本地数据库,写完后扔一个消息到消息队列(如 RabbitMQ 或 Kafka)。然后有一个独立的消费者服务,去慢慢调用外部 API。如果调用失败,放入重试队列,指数退避重试。
在代码里,要处理好“幂等性”。因为网络波动,消息队列可能会重复消费。你的代码必须保证,同一个客户数据被推送两次,不会在 ERP 里生成两张发票。这通常需要在数据库里加唯一索引,或者在外部系统记录已处理的消息 ID。
还有 Webhook 的签名验证。当外部系统回调你的 CRM 时,一定要校验签名。我见过有竞争对手模拟回调请求,批量往 CRM 里灌垃圾数据,把销售的数据分析搞得一团糟。这种安全细节,在写 POST /api/webhook 时就要加上,别等出了事再补。
CRM 系统有个特点,数据只增不减。客户越来越多,跟进记录越来越多,日志越来越多。
刚开始可能觉得 MySQL 扛得住,等过了两年,数据量到了千万级,一个简单的“搜索客户”都要跑 10 秒。
所以在编写代码的初期,就要为搜索留出余地。不要指望 LIKE '%keyword%' 能解决所有问题。如果业务对搜索要求高,尽早引入 Elasticsearch。
在代码架构上,把“写”和“读”分开。复杂的统计报表,不要直接查业务库。可以写个定时任务,把统计数据预计算好,存到一张 report_daily_stats 表里。销售看报表时,直接查这张小表,秒开。
我曾经负责过一个模块,是统计销售人员的“跟进热度”。逻辑是计算过去 30 天每个销售的跟进次数、通话时长、邮件数。最开始我是实时聚合查询,结果每到月底,销售一看报表,系统就卡死。后来我改成了 T+1 模式,每天凌晨算好昨天的数据存起来,查看时直接读结果。虽然数据不是实时的,但对于管理报表来说,完全够用,系统负载也降下来了。
在代码里,要善用缓存。比如“数据字典”、“部门结构”、“权限配置”这些不常变的数据,全部扔进 Redis。别每次请求都去查数据库。但是,缓存更新是个坑。当管理员修改了部门结构,记得要把相关的缓存 Key 删掉或者更新。代码里最好封装一个统一的缓存管理工具类,别到处散乱地写 redis.set。
CRM 系统里存的是公司的核心资产——客户数据。这玩意儿要是丢了或者乱了,公司可能直接瘫痪。
所以,测试代码的覆盖率可以不高,但核心流程的测试必须得有。特别是“线索分配”、“合同金额计算”、“权限校验”这三个地方。
我习惯写一些集成测试脚本,模拟一个销售从录入线索到成交的全过程。每次代码上线前,自动跑一遍。
关于部署,千万别直接在生产环境改数据库结构。一定要用迁移工具(Migration),比如 Flyway 或 Liquibase。把数据库的变更也当成代码来管理。这样回滚的时候,数据库也能跟着回滚。
还有备份。代码里可以没有注释,但不能没有备份策略。除了数据库的主从备份,还要有冷备。我见过最惨的案例,运维误操作 DROP TABLE,主从同步瞬间把从库也删了。幸好有每天的 S3 冷备,才找回了数据。
写了这么多,其实最想说的是,CRM 系统的代码编写,技术难度可能不是最高的,但业务复杂度是最高的。
你写的每一行代码,都在定义销售怎么工作,定义公司怎么管理客户。
有时候,产品经理提的需求在技术上很蠢,比如要在一个列表页展示 200 个字段。作为开发,你不能直接说“不行”,你得告诉他,这样会导致页面加载慢,销售会投诉。然后给出一个方案:默认展示 10 个,支持自定义列。
有时候,销售抱怨系统难用,不是代码写得烂,是流程本身就不合理。这时候,代码解决不了问题,得去开会,去吵架,去优化流程。
我见过最成功的 CRM 项目,不是代码写得最优雅的,而是最懂业务的。那个系统的架构师,甚至能跟着销售出去跑两天客户,看看他们到底在什么场景下用手机,在什么情况下需要快速记笔记。
所以,如果你现在正准备接手一个 CRM 的开发任务,别急着打开 IDE。先去跟销售聊聊天,请他们喝杯咖啡,听听他们骂现在的系统哪里不好用。
回到代码本身,保持敬畏。变量命名规范点,注释写清楚点,尤其是那些为了兼容旧业务逻辑而写的“奇怪代码”,一定要注明 // TODO: 这里是因为 2022 年双 11 活动特殊的折扣逻辑,别删。
这行代码可能救了你未来的命。
夜深了,烟也抽完了。屏幕上的 bug 终于修好了,权限逻辑加上了数据范围校验。我提交了代码,写了句注释:“修复销售无法查看共享客户的 bug,增加缓存失效处理。”
合上电脑,走出办公室,天已经蒙蒙亮了。CRM 系统就像个永远长不大的孩子,你喂它代码,它吃业务数据,然后不断给你制造新的麻烦。但看着销售团队因为系统顺畅而签单越来越多,那种成就感,大概就是我们这些码农继续熬下去的理由吧。
编写 CRM 代码,其实就是在编织一张网,网住的是客户,留住的是人心。技术只是手段,理解生意,才是核心。别让你的代码,成了业务奔跑的绊脚石。
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
悟空CRM产品更多介绍:www.5kcrm.com







 豫公网安备 41010702002713号