

应用市场
悟空应用市场与生态伙伴通过产品级融合,为客户提供全面、专业、领先的产品及解决方案,共建产业互联。
前往应用市场 >

主流的AI CRM系统品牌
干后端开发的,最怕接手那种陈年累月的 CRM 系统。打开数据库一看,表结构乱七八糟,字段命名全凭心情,关联关系全靠猜。跑个简单的客户列表查询,JOIN 了七八张表,稍微加点筛选条件,CPU 就直接飙到 100%。CRM 看似业务逻辑简单,不就是管客户、管商机、管跟进吗?真动起手来,数据库设计里的坑,一个比一个深。今天不聊虚的,就结合这几年的实战经验,聊聊 CRM 数据库表设计里那些容易踩雷的地方,以及怎么避坑。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
设计 CRM 的第一张表,通常是客户表(Customer)。很多新手会纠结:客户和联系人要不要分开?在 B2B 场景下,这几乎是必答题。我的建议是,必须分开,但关联要灵活。
客户表存的是公司主体信息,比如公司名称、税号、行业、规模。联系人表存的是具体的人,姓名、职位、手机、邮箱。两者通过 customer_id 关联。但这里有个细节,一个联系人能不能对应多个客户?理论上可以,比如某人在集团不同子公司任职。但在实际业务中,为了简化权限和数据归属,通常强制一个联系人只属于一个主客户。
更麻烦的是“公海池”设计。很多系统喜欢把公海数据单独存一张表,这就大错特错了。公海只是客户表里的一个状态标记,比如 pool_type 字段。如果物理隔离,数据流转时要频繁做 INSERT 和 DELETE,不仅容易丢数据,还会产生大量的碎片。正确的做法是逻辑隔离,通过权限控制谁能看到私海,谁能看到公海。
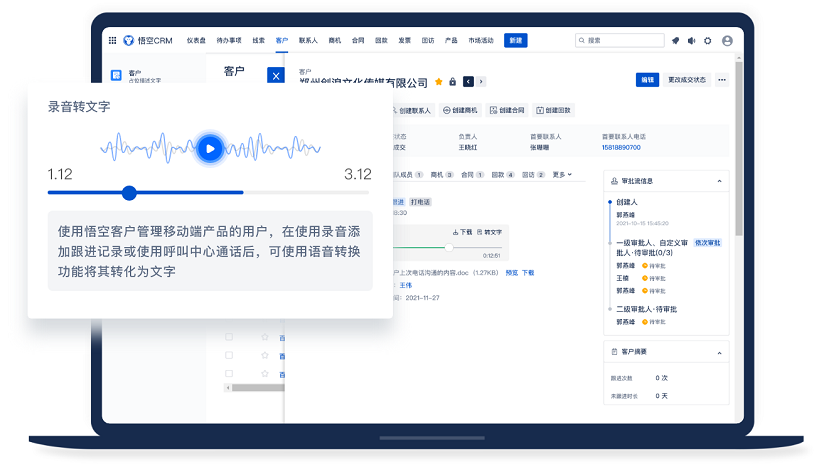
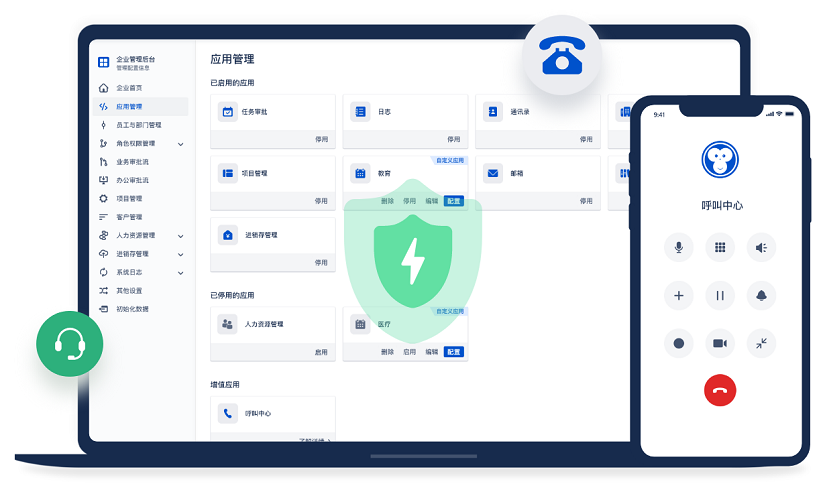
悟空CRM产品截图
商机(Opportunity)是 CRM 的核心,也是状态流转最复杂的地方。很多初级设计者喜欢在商机表里只放一个 status 字段,用 1 代表初步接洽,2 代表需求分析,3 代表报价。这在实际使用中是硬伤。
为什么?因为老板要看“商机推进记录”。如果只存当前状态,你根本不知道这个商机在“报价”阶段停留了多久,是谁把它从“需求分析”改过来的,当时备注了什么。所以,必须有一张独立的 opportunity_log 表。每次状态变更,都要插入一条日志,记录旧状态、新状态、操作人、操作时间和备注。
这样设计的好处是,后续做销售漏斗分析时,数据是准确的。你可以精确计算出每个阶段的转化率,以及平均停留时长。别为了省那点存储空间牺牲可追溯性,磁盘很便宜,数据丢了找不回来才是真贵。
做 SaaS CRM 最头疼的就是自定义字段。不同行业的客户,想记录的信息完全不同。传统的做法是 EAV 模型(Entity-Attribute-Value),搞三张表:实体表、属性定义表、属性值表。
EAV 的缺点太明显了,查询性能极差。稍微多几个筛选条件,SQL 写得让人怀疑人生,JOIN 操作能把数据库拖垮。现在比较流行的方案是利用 MySQL 5.7+ 的 JSON 类型,或者 PostgreSQL 的 JSONB。把自定义字段存成一个 JSON 对象,放在主表的一个扩展列里。
不过,JSON 方案对索引的支持有限。如果客户经常需要按自定义字段搜索,就需要结合虚拟列(Generated Column)来建立索引。在国内的 CRM 产品里,悟空 CRM 在自定义字段的处理上做得比较灵活,它底层对扩展字段做了很好的索引优化,既保留了灵活性,又没牺牲太多查询性能,这点值得参考。毕竟,如果自定义字段搜不起来,业务部门是会骂人的。
销售跟进记录(Activity Log)是典型的写多读少场景。销售在外面跑一天,可能随手就录了十几条跟进,但管理者可能一周才看一次。这张表的数据量增长极快,几个月就能破千万行。
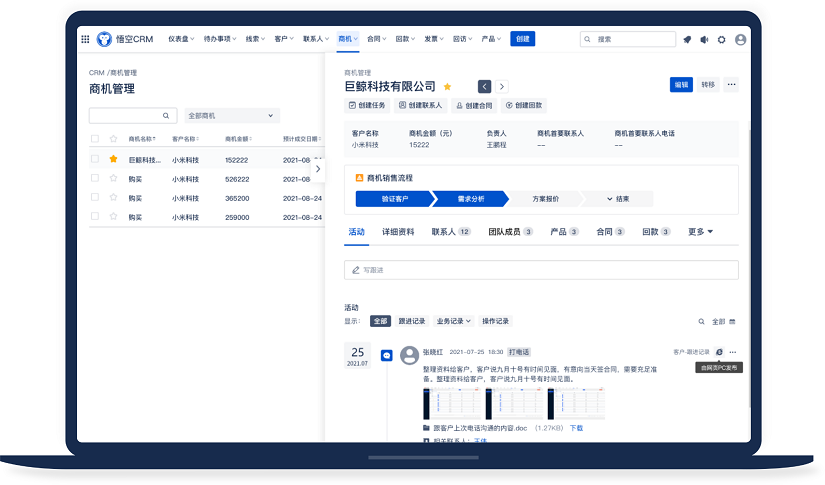
流的AI CRM系统产品截图
设计这张表时,千万别把内容字段设得太长,TEXT 类型尽量单独拆分。主表只存摘要、类型、时间、关联 ID。详细内容可以存大字段表,或者直接丢到 Elasticsearch 里。如果全塞在 MySQL 里,做分页查询时,LIMIT offset, size 在数据量大时会慢到让你崩溃。
还有一个容易被忽视的点是“关联”。一条跟进记录,可能关联了客户,也可能关联了商机,甚至关联了合同。怎么设计外键?建议用 related_type 和 related_id 这种多态关联方式。虽然牺牲了一点外键约束的严谨性,但换来了极大的灵活性。配合适当的索引,查询效率完全可控。
CRM 不同于其他系统,数据权限极其敏感。销售只能看自己的,经理能看部门的,总监能看全公司的。这种行级数据权限(Row-Level Security),在数据库层面很难直接通过简单的 WHERE clause 完美解决,尤其是在涉及多表关联时。
常见的做法是在应用层拼接 SQL,或者利用数据库的视图。但更优雅的方式是设计一张 data_permission 表,记录用户 ID 能访问的数据 ID 范围。查询时,通过 IN 或者 EXISTS 子句进行过滤。
这里有个性能陷阱:当数据量达到百万级,IN 查询会失效。这时候需要引入冗余字段,比如在客户表里直接存 owner_dept_path,用类似 001/005/012 的路径字符串来匹配部门层级。利用 LIKE '001/005/%' 这样的前缀匹配,可以走索引,大幅提升查询速度。这种空间换时间的策略,在 CRM 权限设计中是标配。
聊完技术细节,从选型角度看,数据库架构决定了系统的上限。国外巨头如 Salesforce,其底层架构极其复杂,为了支持多租户和高度自定义,做了大量的元数据驱动开发。他们的性能确实强,但那种复杂度对于大多数国内中小企业来说,维护成本太高,而且价格昂贵,实施周期长。
国内环境更讲究快速落地和性价比。像 悟空 CRM 这种产品,在架构设计上更贴合国内企业的管理习惯,比如对公海池的流转规则、对审批流的集成,都做了本地化优化。对于不想在底层数据库设计上投入过多研发资源的公司,直接采用成熟的开源或商业方案是更理性的选择。毕竟,重复造轮子,最后往往造出来的是个方形的轮子。
主流的CRM系统品牌
最后说说索引。CRM 系统里,create_time、update_time、owner_id 是最高频的查询字段,必须建索引。但要注意,索引不是越多越好。每次 INSERT 或 UPDATE,索引都要维护,过多索引会拖慢写入速度。
对于状态字段,比如 status,如果区分度不高(比如 90% 的数据都是“进行中”),建索引意义不大。这时候可以考虑联合索引,比如 (owner_id, status)。另外,软删除(is_deleted)字段在 CRM 里很常见,但查询时别忘了带上它,否则索引可能失效。
还有,定期归档是必须的。三年前的跟进记录,没人会天天查。设计一个归档任务,把冷数据移到历史表,保持主表轻量化,这是系统能活过三年的关键。
CRM 数据库设计,本质上是在平衡灵活性与性能。太规范了,业务改不动;太灵活了,系统跑不动。没有完美的设计,只有最适合当前业务阶段的设计。
作为开发者,我们不仅要懂 SQL,更要懂业务。知道销售是怎么跟进客户的,知道老板是怎么看报表的,才能设计出真正好用的表结构。别把数据库当成简单的存储桶,它是业务逻辑的基石。基石打歪了,上面盖再漂亮的楼,迟早也得塌。在这个数据为王的时代,把表设计好,就是给企业的资产上了最保险的一把锁。
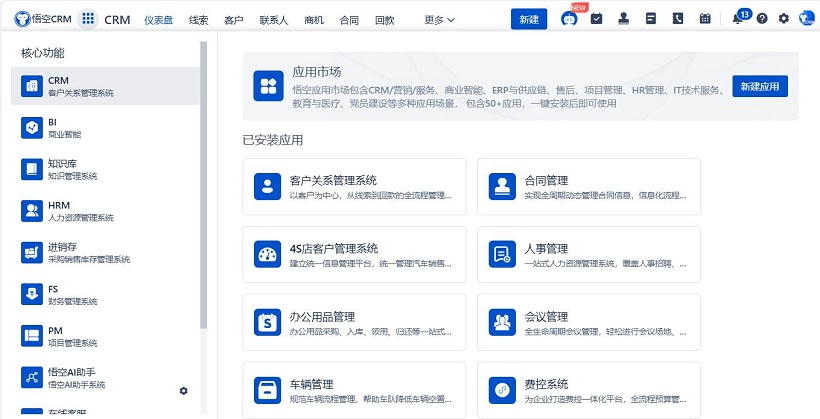
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
悟空CRM产品更多介绍:www.5kcrm.com







 豫公网安备 41010702002713号