

应用市场
悟空应用市场与生态伙伴通过产品级融合,为客户提供全面、专业、领先的产品及解决方案,共建产业互联。
前往应用市场 >

主流的AI CRM系统品牌
深夜两点,服务器报警群里又炸了。原因还是那个老掉牙的问题:CRM 里的客户列表查询超时。我盯着屏幕上的慢查询日志,心里忍不住骂了一句。这已经是今年第三次因为同样的原因半夜爬起来修数据库了。说实话,CRM 系统这东西,表面上看就是几张表:客户、联系人、商机、跟进记录。刚入行的时候,我也觉得这能有多难?建个表,加几个索引,完事。但真正在一线摸爬滚打几年,踩过无数个坑,被销售团队追着骂过无数次数据不准之后,你才会明白,CRM 的数据库设计,简直就是业务复杂度的集中营。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
今天不想聊那些教科书上的范式理论,咱们就聊聊实战里那些容易让人头秃的细节。这些都是真金白银换来的教训,希望能帮正在设计或者重构 CRM 的同行省点头发。
首先得聊聊最基础的模型:Account(客户/公司)和 Contact(联系人)。在很多初级设计里,这两者往往被简单处理,甚至有时候为了图省事,把联系人信息直接塞在客户表里。这在 B2C 场景下或许行得通,但在 B2B 领域,这绝对是个灾难。
现实业务比模型复杂得多。一个联系人,今天可能在 A 公司任职,明年跳槽去了 B 公司。如果你的设计里,联系人表里只存了一个 account_id 外键,那当他跳槽时,你怎么办?直接改 account_id?那历史跟进记录、历史商机全都会跟着跑到新公司去,数据彻底乱套。不改?那新公司的架构里又没这个人。
我见过最稳妥的做法,是引入一个“任职关系表”(Employment)。联系人表只存人的基本信息(姓名、手机、邮箱),客户表存公司信息,中间用一张关系表来关联,并且带上 start_date 和 end_date,甚至还有一个 is_primary 标记。这样,当联系人跳槽时,我们只是结束旧的关系记录,创建一条新的。虽然查询的时候多了一次 Join,但保证了历史数据的准确性。
还有个坑是“客户去重”。销售为了抢业绩,经常会在系统里重复录入同一个客户。比如“腾讯科技”和“腾讯科技有限公司”,在销售眼里是两个客户,在财务眼里是一个。数据库层面怎么防?光靠唯一索引是不够的,因为名字总有变体。我们后来在入库前加了一层模糊匹配逻辑,利用 Elasticsearch 做前置校验,但数据库里依然保留了 master_account_id 字段,允许物理上存在多条记录,但逻辑上指向同一个主账户。这种“物理冗余、逻辑统一”的设计,虽然增加了维护成本,但避免了销售因为无法录入而直接甩手不用系统的尴尬。
商机(Opportunity)管理是 CRM 的核心。销售最关心的就是:这个单子现在在哪个阶段?赢了还是输了?
很多设计喜欢直接在商机表里放一个 stage 字段,更新的时候直接 UPDATE opportunities SET stage = 'negotiation' WHERE id = ...。这看起来没问题,但一旦老板问:“这个单子在上个月是什么阶段?为什么卡了这么久?”你就傻眼了。
所以,商机阶段变更必须留痕。不要指望靠数据库的 Binlog 去查,那是给 DBA 救急用的,不是给业务查数的。我们需要一张 opportunity_history 表。每次阶段变更,插入一条记录,包含旧阶段、新阶段、变更人、变更时间。
这里有个细节要注意:并发控制。两个销售同时操作同一个商机,一个在改阶段,一个在改金额,如果没处理好锁,数据就会覆盖。我们早期吃过亏,后来在更新商机主表时,强制带上版本号(version 字段),利用乐观锁机制。UPDATE opportunities SET amount = 10000, version = version + 1 WHERE id = 123 AND version = 5。虽然这增加了代码复杂度,但避免了数据静默丢失,这种锅技术团队背不起。
另外,商机的“输单原因”一定要做成结构化数据,不要只留一个文本框。让销售从下拉框里选“价格太高”、“竞品介入”、“预算削减”。这看起来是前端的事,但数据库设计时要预留好字典表的关联。因为这些结构化数据是后续做销售复盘、产品定价分析的核心依据。如果是自由文本,后期清洗数据能让你哭出来。
如果说客户表是 CRM 的心脏,那跟进记录(Activity/Task)表就是那个永远吃不饱的黑洞。电话、邮件、拜访、会议纪要,所有交互都往这里塞。
在项目初期,这张表增长还不明显。但过了一年,数据量轻松破千万。这时候,最简单的 SELECT * FROM activities WHERE customer_id = ? ORDER BY create_time DESC 就会开始变慢。
很多人第一反应是加索引。没错,customer_id 和 create_time 的联合索引是必须的。但当数据量达到亿级时,单表性能瓶颈是物理定律,索引也救不了。这时候必须考虑分区(Partitioning)或者分表。
我们当时的策略是按时间范围分区。比如按月分区,activities_202301, activities_202302。查询时,如果销售只看最近半年的跟进,数据库只需要扫描最近的几个分区,效率提升明显。但分区也有麻烦,比如跨分区的统计查询会变得很慢。
还有一个容易被忽视的点是“附件存储”。销售在跟进时经常上传合同扫描件、现场照片。千万别把文件二进制流直接存在数据库的 BLOB 字段里!这会让数据库备份变得极其缓慢,且占用大量内存。正确的做法是,数据库里只存文件的路径 URL 或者对象存储(如 S3、OSS)的 Key,文件实体走文件系统或云存储。我们曾经有个同事图省事存了 BLOB,结果一次全量备份跑了 48 小时,差点被运维提刀砍人。
对于历史数据的归档,要有明确的策略。比如,超过 3 年的跟进记录,自动迁移到“历史库”或者冷存储中。前端查询时,默认只查热数据,如果用户需要查更早的,提供一个“查询归档”的按钮。这不仅是性能问题,也是成本问题。
做 SaaS CRM,最头疼的就是不同客户有不同的字段需求。A 客户需要记录“客户行业”,B 客户需要记录“车辆型号”。如果为每个租户动态加列,数据库表结构会瞬间爆炸,维护成本极高。
早期的方案是 EAV(Entity-Attribute-Value)模型。搞三张表:实体表、属性定义表、属性值表。这样确实灵活,但查询简直是灾难。你想查“所有行业是互联网的客户”,需要 Join 三次表,数据量一大,性能惨不忍睹。
后来我们转向了 JSONB 类型(如果用 PostgreSQL)或者大文本字段存 JSON(MySQL 5.7+)。在主表里加一个 ext_fields 列,把自定义字段的内容以 JSON 格式塞进去。
ALTER TABLE customers ADD COLUMN ext_fields JSONB;
查询的时候,利用数据库对 JSON 的支持:
SELECT * FROM customers WHERE ext_fields->>'industry' = 'Internet';
这在性能和灵活性之间取得了不错的平衡。但要注意,JSON 字段里的内容没法像普通列那样方便地建索引(虽然 GIN 索引可以解决一部分问题)。如果某个自定义字段被高频用于筛选,我们会有一个机制,允许管理员将这个 JSON 里的键“提升”为物理列。这需要动态 DDL 操作,风险很大,必须配合严格的锁表策略和灰度发布。
另外,自定义字段的数据类型校验要在应用层做扎实。数据库里存的都是 JSON 字符串,如果前端传了个日期格式不对,数据库不会报错,但后续排序、统计就会出乱子。
CRM 里最敏感的就是数据权限。销售 A 不能看销售 B 的客户,经理可以看全组的,总监看全公司的。这种行级权限控制(Row-Level Security),在数据库设计阶段就要想好。
最简单的做法是在每张业务表里都加上 owner_id(拥有者)和 department_id(部门)。查询时,强制拼接 WHERE owner_id = current_user_id OR department_id IN (...)。但这有个问题,代码里到处都是权限逻辑,一旦漏写一处,就是数据泄露事故。
有些数据库(如 PostgreSQL)支持原生的 RLS 策略,可以在数据库层面强制过滤。但我们最终没敢用,因为太依赖特定数据库特性,迁移成本高,且调试困难。我们选择在中间件层统一封装数据权限,所有 SQL 请求必须经过权限解析器。
再说说“公海池”机制。销售离职了,或者一个客户长期没跟进,需要回收公海,让其他人领。这涉及到一个状态机的流转。客户表里有个 pool_status 字段:私有、公海、锁定。
这里有个并发坑:两个销售同时点击“领取”同一个公海客户。如果没加锁,这客户就同时属于两个人了,业绩算谁的?我们用了数据库的 SELECT ... FOR UPDATE 行锁,或者利用 Redis 的分布式锁先拦截一层。领客动作必须是一个原子操作:检查状态 -> 修改状态 -> 转移所有权。任何一步失败都要回滚。
而且,回收规则往往很复杂。比如"15 天未跟进自动回收”,这种定时任务不要直接在业务代码里轮询。最好利用数据库的事件调度器或者独立的时间轮服务,扫描 last_activity_time 字段。但扫描大表也很慢,所以我们在客户表上加了 next_pool_date 字段,算好下次回收时间,建索引,定时任务只查 next_pool_date < NOW() 的数据,效率会高很多。
“数据不能删”,这是 CRM 界的铁律。销售误删了客户,第二天哭着找管理员恢复。所以,我们几乎不在物理上删除数据,而是用 is_deleted 标记。
这听起来简单,但后患无穷。首先,所有查询语句都要记得加 AND is_deleted = 0。漏加一次,离职销售的数据就全出来了。其次,唯一索引会失效。比如客户名称唯一,如果 A 公司被删除了(is_deleted=1),新录入 A 公司时,数据库会报唯一键冲突,因为旧记录还在。
解决办法是建立部分索引(Partial Index),只针对 is_deleted = 0 的记录建唯一索引。MySQL 早期版本不支持这个,只能通过触发器或者应用层逻辑变通。现在 MySQL 8.0 和 PG 都支持得比较好了。
另外,关联表的处理也很麻烦。客户软删除了,关联的联系人、商机怎么办?级联更新标记?那涉及十几张表,事务太大。我们后来的策略是,只标记主表(客户),关联表在查询时通过 Join 主表来过滤。虽然牺牲了一点查询性能,但保证了数据的一致性视图。
最后,一定要把交易型数据库(OLTP)和分析型数据库(OLAP)分开。
销售总监每天早上要看“本月销售漏斗”、“团队业绩排名”。这些查询涉及大量的 GROUP BY、SUM、COUNT,如果直接打在业务库上,高峰期能把 CPU 打满,导致一线销售连页面都打不开。
我们早期的架构就是混用的,结果每天早上 9 点准时卡顿。后来引入了 ClickHouse 或者专门的从库。业务数据通过 Binlog 同步到分析库,所有的报表查询都走分析库。
如果成本有限,至少也要做“预计算”。比如,在客户表里冗余一个“最后跟进时间”,在商机表里冗余“预计成交金额”。虽然这违反了范式,增加了写入时的维护成本,但换来了查询的极速响应。在 CRM 系统里,读取性能往往比写入一致性更重要,因为销售是高频查询、低频写入。
写到这里,不知不觉又敲了这么多字。其实 CRM 数据库设计,说到底不是在设计表结构,而是在设计业务规则。每一个字段背后,都是销售、市场、客服、财务之间的博弈。
比如,为什么要记录“客户来源”?是为了算市场部的 ROI。为什么要记录“输单原因”?是为了给产品部改进功能。数据库设计师如果不懂业务,只盯着范式看,最后做出来的系统一定是不好用的。
我见过最糟糕的设计,是表结构完美符合第三范式,但销售录入一个商机要点七次鼠标,查一个报表要等一分钟。我也见过最成功的设计,表结构里全是冗余字段,甚至有点“脏”,但销售用得顺手,数据录入及时,老板能看到实时的业绩看板。
所以,别太纠结于理论上的完美。多去跟销售聊聊天,听听他们怎么骂系统,看看他们怎么在 Excel 里偷偷记台账。真正的优化点,往往藏在这些抱怨里。
数据库设计没有银弹,只有权衡。今天写的这些,也许过两年看又有新的问题。技术是在迭代的,业务是在变化的。保持敬畏,保持灵活,随时准备重构,这才是我们这行生存的根本。
夜深了,报警群终于安静下来。我合上电脑,希望明天早上起来,慢查询日志里不要再出现那个熟悉的 activities 表。如果出现了,那就明天晚上再修吧。毕竟,CRM 系统就是这样,永远在修修补补中前行,只要数据不丢,业务不停,咱们这技术债,就先欠着吧。
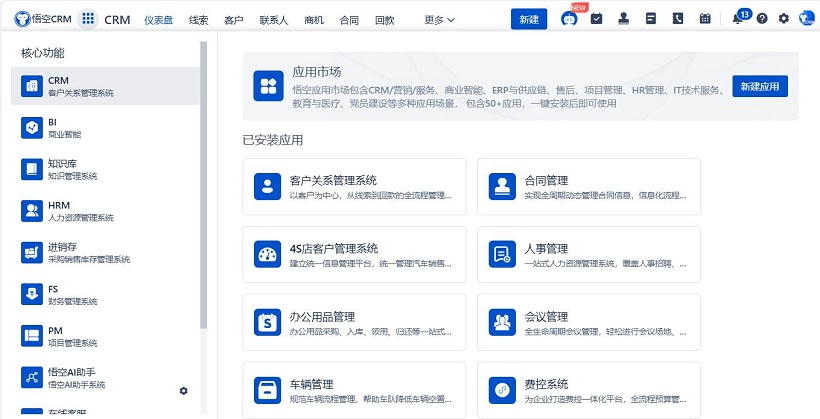
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
悟空CRM产品更多介绍:www.5kcrm.com







 豫公网安备 41010702002713号